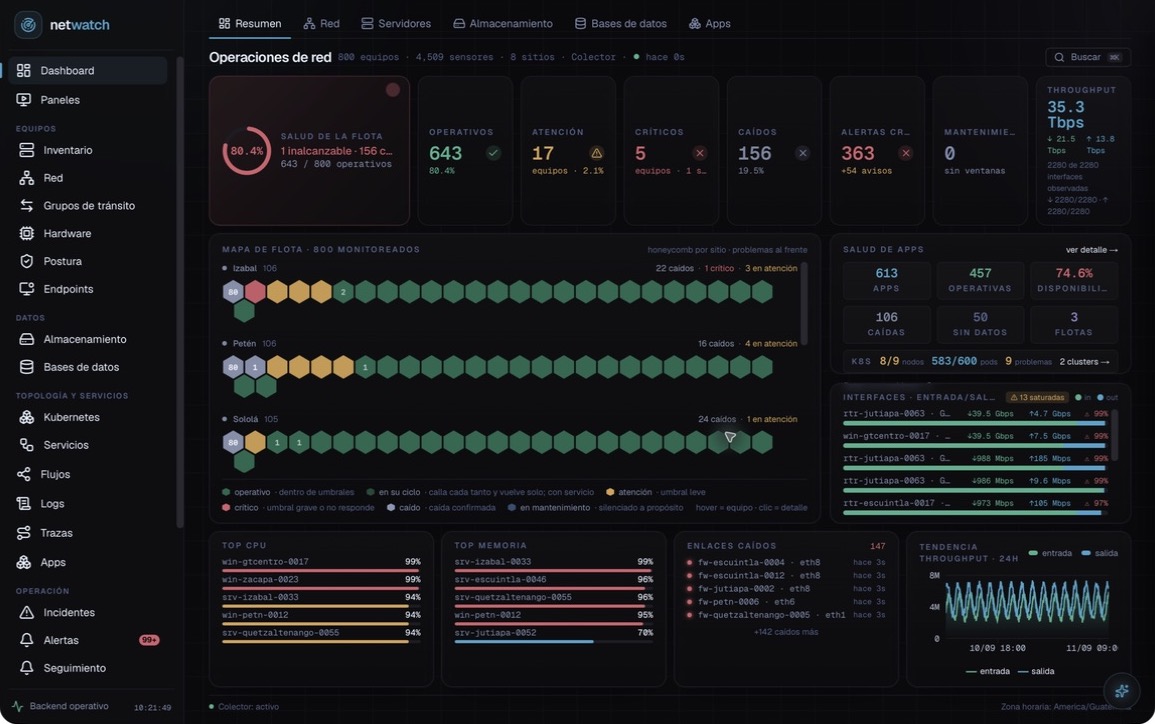
Todo lo que hay detrás del menú.
Agrupado igual que en el producto. Los módulos de automatización y análisis con IA se encienden por plataforma; el resto viene de fábrica.
Lo primero que ve el NOC: el estado de todo, y los tableros que cada equipo se arma a su medida.
Resumen
Salud de la flota, KPIs de operativos, en atención, críticos y caídos, mapa de flota por sitio, apps, enlaces saturados y throughput — en una pantalla sin scroll que se refresca sola.
Paneles
Tableros a tu medida con las gráficas que tu operación necesita ver en el televisor del NOC: multi-equipo, multi-métrica, con el rango que elijas.
Cada cosa con dirección IP en tu red, de cualquier fabricante, y lo que le pasa por dentro.
Inventario
Todos los equipos con su sitio, tipo, identidad SNMP, colector y estado. Alta guiada, etiquetas y descarte con historial.
Red
Miles de interfaces una por una: tráfico, saturación contra la capacidad del puerto, errores CRC, descartes, difusión, flapping y último cambio de estado.
Grupos de tránsito
Tus salidas a internet y enlaces entre sedes como un conjunto: cuánto entra y sale por cada uno, y cuándo el tráfico se movió de un proveedor a otro.
Sesiones BGP/OSPF
Estado de cada sesión y vecino, tiempo establecido, reconexiones y número de rutas — para saber si un enlace «arriba» sigue enrutando.
Hardware
Temperatura, ventiladores, fuentes, módulos, presupuesto PoE y UPS, con sus umbrales por fabricante.
Postura
Firewalls, balanceadores, DDI y virtualización en una sola vista: clústeres HA, túneles VPN, licencias y contratos por vencer, certificados, VIPs y sus backends.
Endpoints
Todo lo conectado —computadoras, cámaras, impresoras, teléfonos— aunque no lo monitorees: en qué puerto vive, su dirección y su fabricante.
Donde de verdad duele cuando falla: el disco y la base.
Almacenamiento
Uso de cada volumen y un pronóstico de cuándo se llena, para avisar antes de que un disco lleno detenga un servicio.
Bases de datos
SQL Server, Oracle, PostgreSQL, MySQL, MongoDB, Redis, HANA e InfluxDB con un usuario de solo lectura: conexiones, esperas, réplicas, respaldos y diagnóstico de causa por motor.
Quién depende de quién, para avisar por el servicio y no por cada pieza.
Topología
El cableado real se dibuja solo a partir de LLDP y CDP; sirve para que una caída del núcleo se reporte como una sola causa con todo lo que arrastra.
Kubernetes
Clústeres, nodos, cargas, pods y volúmenes con sus señales de presión, reinicios y errores de despliegue.
Servicios
Mapas de dependencias de un sistema: equipos, VIPs, bases y sondas web con el caudal por cable, y el estado del servicio como un todo.
Apps
Sondas web, DNS y certificados vistos como los ve el usuario: disponibilidad, tiempo de respuesta y días para que venza el certificado.
Lo que los equipos y las aplicaciones cuentan por su cuenta.
Flujos
NetFlow y sFlow de tus propios routers: conversaciones y aplicaciones top por puerto, para saber quién se está comiendo el enlace.
Logs
Syslog de firewalls, switches y servidores interpretado con severidad real y equipo de origen, agrupado por patrón para ver lo nuevo y lo repetido.
Trazas
Trazas OTLP de tus aplicaciones: latencia por operación, errores y el camino de una petición entre servicios.
El trabajo diario del NOC y lo que se le entrega a la gerencia.
Incidentes
Cada incidente con su causa raíz, evidencia, cuánto duró y quién fue avisado.
Alertas y seguimiento
Alertas activas, reglas por ámbito, reconocer, silenciar, retirar y la bandeja de seguimiento de lo crónico.
Historial
Todo lo que pasó, cuándo empezó de verdad y cuándo terminó — la memoria forense de tu operación.
SLA
Disponibilidad medida por sitio y flota contra el objetivo que tú fijes, y el reporte mensual en Word listo para entregar.
Gerencia
El tablero mensual de dirección: cumplimos o no, qué nos costó en dinero, dónde está el riesgo y qué hacemos.
Mantenimiento
Ventanas programadas que silencian una zona el tiempo justo sin perder el registro de lo que pasó.
Contactos
A quién se le avisa, por qué canal y con qué cadencia, por sitio y por severidad.
Del aviso a la acción y a la explicación.
Automatizaciones
Plantillas de Ansible, Python y Bash ejecutadas por un executor dentro de tu red: respaldos, cambios masivos, remediaciones autorizadas y programaciones, con resultado por equipo.
Análisis IA y copiloto
Un asistente sobre tus propios datos que explica qué pasó, arma el plan y redacta el informe; y un agente que investiga por ti.
Cinco formas de obtener el dato, sin instalar software en todo.
En un cliente típico conviven todas. Un solo colector cubre la sede; toda la telemetría sale cifrada hacia un único destino.
| Forma | Cómo funciona | Dónde se usa |
|---|---|---|
| Sin agente, por SNMP | El colector consulta el equipo (v1, v2c o v3 con autenticación y cifrado). | Switches, routers, firewalls, balanceadores, APs, UPS, servidores |
| Sin agente, por sondeo activo | El colector le pregunta al servicio: ping, HTTP/HTTPS, consulta DNS real. | Enlaces WAN, sitios publicados, servidores DNS, cualquier IP |
| Consulta directa a la base | Un usuario de solo lectura consulta las vistas de estado del motor. | SQL Server, Oracle, PostgreSQL, MySQL, MongoDB, Redis, HANA, InfluxDB |
| Con agente | Un binario único (Linux, Windows, macOS) instalado en el servidor. | Servidores donde SNMP no alcanza o no está permitido |
| Recepción pasiva | El equipo envía y netwatch recibe: syslog, flujos, trazas, métricas. | Firewalls, switches, routers, aplicaciones propias |
Qué hace falta habilitar del lado del cliente
- Una comunidad SNMP de solo lectura (o un usuario SNMPv3) en los equipos de red.
- Un usuario de solo lectura en cada base de datos que quieras vigilar.
- Apuntar el syslog y los flujos de tus equipos al colector de la sede.
- Un servidor Linux pequeño por sede para el colector; nada más.
Lo que netwatch no exagera
Un campo que el equipo no reporta no se juzga ni se pinta en verde: se dice «no medido». Una consulta que falla nunca se presenta como un cero. Y una alerta solo se da por resuelta cuando netwatch vuelve a ver el equipo sano, no cuando deja de verlo. Un sistema de monitoreo que promete de más es peor que uno que no se instaló.
Dentro de tu red, con tus reglas.
Sedes remotas, redes cerradas, varios clientes en la misma plataforma. Todo vive en tu organización y no pagas por equipo monitoreado.
Tus datos, en tu almacén
Métricas, logs y trazas viven en bases dentro de tu organización. Funciona sin internet y nada viaja a nubes ajenas.
Un colector por sede
Un solo binario estático, sin dependencias, que se instala con un enlace de un solo uso y cubre toda la sede.
Un token, un puerto
Cada sede reporta con un único token de ingreso por un solo puerto de salida. Tu equipo jamás guarda las credenciales de las bases.
Actualización firmada
La flota de colectores se actualiza sola desde tu panel, con firma verificada y reversa automática si algo sale mal.
Quién ve qué
Perfiles de visibilidad por dominio: un cliente o un área ve solo sus sitios, sus equipos y sus alertas.
El manual, dentro del producto
La guía de operación y soporte se lee desde el propio panel, con capturas y procedimientos.
Tema oscuro y claro
Pensado para la sala de control de noche y para la oficina de día.
Español e inglés
Interfaz, avisos y reportes en el idioma de tu equipo.
Un panel, toda tu operación.
Inicia sesión para recorrer los módulos con tus propios datos.
Acceder