Primero confirma. Después molesta.
Casi todas las falsas alarmas nacen de una lectura suelta o de un dato que faltó. netwatch está construido para no caer en ninguna de las dos.
Varias lecturas, no una
Una alerta se confirma con varias muestras seguidas del propio equipo — nunca con una lectura suelta. El tiempo de confirmación se ajusta por regla.
Resuelve solo con evidencia
Una alerta se cierra cuando netwatch vuelve a VER el equipo sano. Si el equipo desaparece o la consulta falla, la alerta sigue viva: ausencia no es recuperación.
«Aún no le toca» no es «caído»
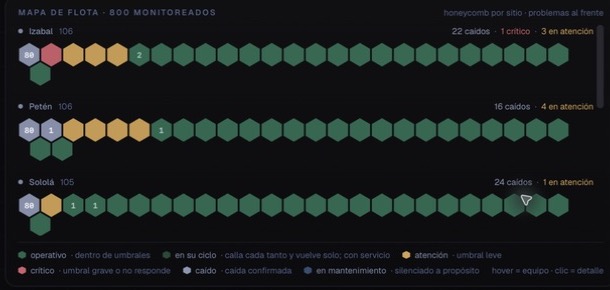
Con miles de equipos, cada uno tiene su turno de sondeo. netwatch distingue un equipo al que todavía no le toca de uno que dejó de responder.
Banda muerta y antirrebote
Un valor que oscila al filo del umbral no enciende y apaga la alerta cien veces: hay una banda de recuperación y un freno al parpadeo.
Así se convierte una tormenta en un solo aviso.
Cuando cae la pieza de la que dependen otras, lo que necesitas saber es cuál cayó y cuántas arrastra. Esto es lo que pasa, minuto a minuto.
- 10:41:05El núcleo dist-central deja de responder.
- 10:41:3037 equipos detrás de él dejan de responder también.
- 10:42:00Segunda lectura sin respuesta: la caída del núcleo se confirma. netwatch consulta la topología y encuentra que los 37 dependen de él.
- 10:42:01Sale UN aviso: «Caída en la sede Central — causa: dist-central · 37 equipos arrastrados». Las 37 alertas quedan agrupadas bajo esa causa, visibles pero silenciosas.
- 11:07:40El núcleo vuelve a responder dos veces seguidas. El incidente se resuelve con evidencia y el historial guarda 26 minutos de caída, con causa y afectados.
Topología, no adivinanza
La dependencia sale del cableado real (LLDP/CDP) y de los mapas de servicio que tú definiste. Sin una relación conocida, netwatch no suprime nada.
Causa raíz con evidencia
Cruza red, logs y trazas para señalar el origen y adjuntar la evidencia: qué se vio, cuándo y en qué equipo.
Un resumen por canal, nunca una avalancha.
Los avisos se juntan en ventanas cortas y salen como un solo mensaje: lo nuevo primero, lo resuelto al final. Lo que ya se resolvió solo no despierta a nadie.
Correo
Un resumen agrupado por ventana, con lo nuevo primero en el asunto, y un recordatorio diario solo de lo crítico que sigue abierto.
Telegram
El mismo resumen en el chat del equipo de guardia, para el que no está frente al correo.
Webhook
Un aviso estructurado hacia el sistema de tickets o el canal de tu equipo, para integrarlo con lo que ya usas.
La cadencia, en tus manos
- Cuánto esperar antes del primer aviso para juntar lo que llegue en la misma ventana.
- Cada cuánto repetir un resumen mientras el problema siga abierto, y un recordatorio diario solo de lo crítico.
- Quién recibe qué: contactos por sitio, por severidad y por canal.
- Con miles de equipos, los mensajes van acotados: nunca una lista interminable en el correo.
Reglas a tu medida, y una bandeja para lo crónico.
Umbrales por ámbito, reglas sobre logs y servicios, ventanas de mantenimiento y las tres acciones del operador — con una diferencia clara entre silenciar, retirar y resolver.
Umbrales por ámbito
Una regla puede aplicar a toda la flota, a un sitio, a un tipo de equipo o a uno solo. El semáforo del tablero sigue esas mismas reglas: lo que ves en rojo es lo que alerta.
Reglas sobre logs
Alertas por patrón de syslog —un mensaje nuevo, uno que se repite demasiado— con la severidad y el equipo de origen.
Reglas por servicio
Cuando defines el mapa de un servicio, netwatch avisa por el servicio completo, no por cada una de sus piezas.
Ventanas de mantenimiento
Programa el trabajo y esa zona se silencia el tiempo justo. Lo que pasó queda registrado; solo no despierta a nadie.
Reconocer, silenciar, retirar
Reconocer detiene los recordatorios; silenciar calla un ruido conocido; retirar es una decisión manual que no se deshace sola. Nada de eso cambia la realidad del equipo.
Historial forense
Cada incidente guarda cuándo empezó de verdad, cuánto duró, cuál fue la causa y a quién se avisó — la evidencia para el informe.
Menos ruido. Más señal.
Inicia sesión para ver las alertas activas, las reglas y el historial con tus propios equipos.
Acceder